



 人民網+
 中國共產黨新聞網
 領導留言板
 強國論壇
 人民視頻
李海洲:做好中文數據標注、夯實國產算力底座,讓AI真正理解中國
 訂閱已訂閱已收藏
 收藏
 小字號
人民網貴陽8月29日電 (記者李麗萍)“一個用英文訓練出來的大模型,代表的不是中國文化,也不是我們的價值觀。”8月28日晚,2026數博會DATA之夜活動中,新加坡工程院院士、香港中文大學(深圳)人工智能學院院長李海洲直言,中文數據標注和國產算力部署,是行業需要持續關注的兩個方向。
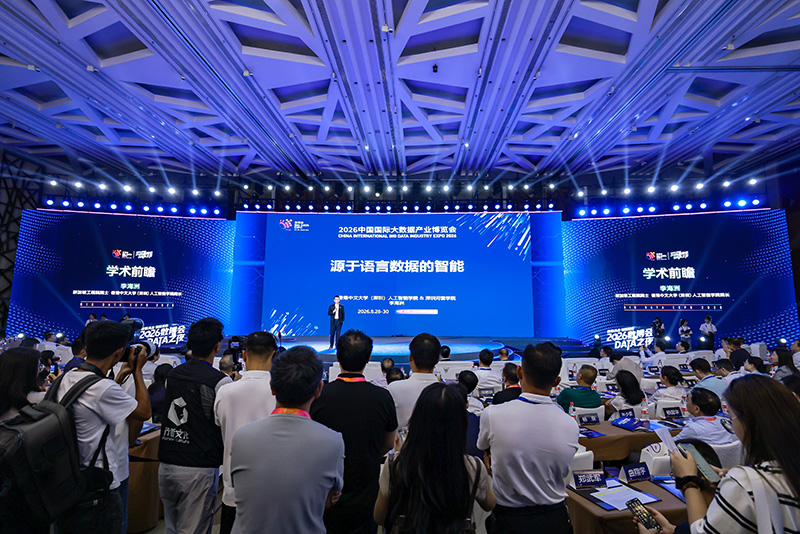
李海洲作主旨演講。主辦方供圖
“過去70年,人工智能的發展從來沒有離開語言。”李海洲表示,語言數據是人工智能的根基。然而,全球公開網頁語言數據中,英文佔比約60.6%,中文僅佔1.3%。這需要業界更多投入。
李海洲認為,更為緊迫的是,人類5000年積累的文本數據,將在2026至2032年被大模型“讀完”。屆時如何繼續供給高質量數據,是行業必須面對的問題。
要破解這一難題,李海洲認為出路之一在於用算法生成數據,而不僅僅是依賴人類文本。他介紹了團隊近期兩項工作,一是在國產算力上完成DeepSeek V4.0 Pro的適配,標志著國產算力正在從推理部署和輕量化微調邁向萬億級超大模型全參數后訓練。二是開發全雙工語音大模型,實現“邊說邊聽”的雙向對話,通過算法生成交互數據進行訓練。
“要讓人工智能真正理解中國的歷史、文化和價值觀,我們必須把中文數據標注做扎實,把國產算力底座做厚實。”李海洲說。
分享讓更多人看到 
 人民日報
 人民網+
 手機人民網
 領導留言板
 人民視頻
 人民智作
人民日報社概況 | 關於人民網 | 報社招聘 | 招聘英才 | 廣告服務 | 合作加盟 | 供稿服務 | 數據服務 | 網站聲明 | 網站律師 | 信息保護 | 聯系我們
人民日報違法和不良信息舉報電話:010-65363263 舉報郵箱:jubao@people.cn
人民網服務郵箱:kf@people.cn 違法和不良信息舉報電話:010-65363636 舉報郵箱:rmwjubao@people.cn
互聯網新聞信息服務許可証10120170001 | 增值電信業務經營許可証B1-20060139 | 廣播電視節目制作經營許可証(廣媒)字第172號
信息網絡傳播視聽節目許可証0104065 | 網絡文化經營許可証 京網文[2020]5494-1075號 | 網絡出版服務許可証(京)字121號 | 京ICP証000006號 | 京公網安備11000002000008號
人 民 網 股 份 有 限 公 司 版 權 所 有 ,未 經 書 面 授 權 禁 止 使 用
Copyright © 1997-2026 by www.people.com.cn. all rights reserved


-
評論

-
關注
微信微博快手
 第一時間為您推送權威資訊
 報道全球 傳播中國
 關注人民網,傳播正能量
